Estimation, intervalles de confiance & tests d'hypothèse (socle)
La statistique inférentielle part d'un échantillon (taille n) pour tirer des conclusions sur la population entière. Elle prolonge le chapitre Probabilités & statistiques (loi normale, échantillonnage, intervalles de confiance) : ici on estime, on encadre et surtout on décide.
A. Estimation ponctuelle : estimateur sans biais
On observe x1,…,xn. Deux estimateurs fondamentaux :
Moyenne empiriquex=n1i=1∑nxi : estimateur sans biais de la moyenne μ de la population (E(X)=μ).
Variance empirique corrigées2=n−11i=1∑n(xi−x)2 : estimateur sans biais de la variance σ2.
⚠️ Le diviseur est n−1, pasn : diviser par n donne une variance biaisée (qui sous-estime σ2). Le −1 compense le fait que x est lui-même estimé à partir des données (perte d'un degré de liberté). On distingue l'estimateur (la formule, variable aléatoire) de l'estimation (la valeur numérique obtenue sur l'échantillon).
B. Intervalle de confiance d'une moyenne, σ inconnu : loi de Student
Quand l'écart-type σ de la population est connu, l'IC à 95% d'une moyenne est [x±1,96nσ] (chapitre parent). Mais en pratique σ est inconnu : on le remplace par s. Si la population est normale, la quantité s/nX−μ ne suit plus une loi normale mais la loi de StudentTn−1 à n−1 degrés de liberté. D'où :
IC1−α(μ)=[x−tn−1;1−α/2ns;x+tn−1;1−α/2ns]
La loi de Student a des queues plus épaisses que la normale (l'incertitude sur s élargit l'intervalle) ; pour n grand, tn−1;0,975→1,96 et on retrouve la normale.
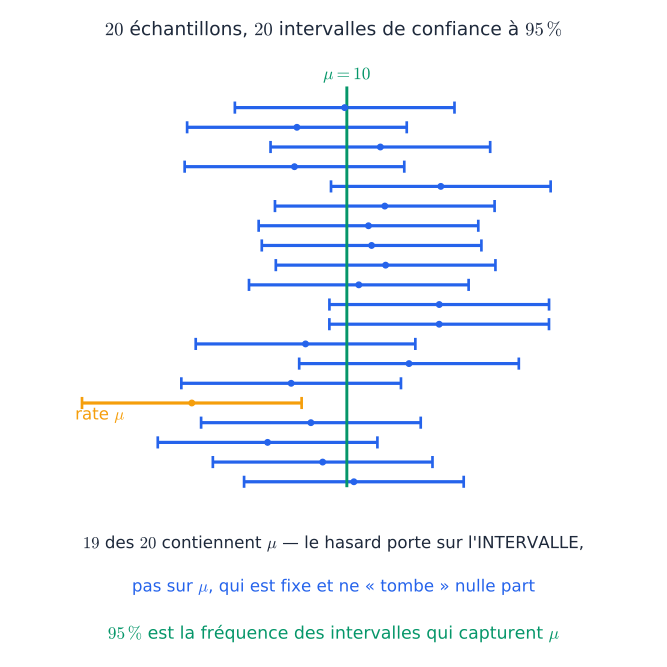
Ce que « 95% » veut dire, et ce qu'il ne dit pas : c'est l'intervalle qui est aléatoire, pas μ. Chaque échantillon en produit un nouveau, et c'est la proportion de ceux qui attrapent μ qui vaut 95%. Ici 20 échantillons de taille n=25 tirés dans N(10;22), demi-largeur 1,96σ/n=0,784 : 19 intervalles contiennent μ=10, un le rate. Une fois l'échantillon tiré, l'intervalle contient μ ou ne le contient pas — dire « μ a 95% de chances d'y être » est le contresens classique. Contre-épreuve sur 4000 échantillons : couverture 94,30%.
C. Intervalle de confiance d'une variance : loi du khi-deux
Si la population est normale, la quantité σ2(n−1)s2 suit une loi du khi-deuxχn−12 (cette hypothèse est ici indispensable, même pour n grand). Comme σ2 est au dénominateur de cette quantité, l'IC de σ2 a des bornes croisées ; et comme la loi n'est pas symétrique, il n'est pas centré sur s2 :
IC1−α(σ2)=[χn−1;1−α/22(n−1)s2;χn−1;α/22(n−1)s2].
(le grand quantile est au dénominateur de la borne inférieure). On obtient l'IC de l'écart-type en prenant les racines carrées.
D. Intervalle de confiance d'une proportion
[f±z1−α/2nf(1−f)] avec f la fréquence observée, sous conditionsn≥30, nf≥5 et n(1−f)≥5. L'estimation ponctuelle (x ou f) est toujours au centre de l'IC.
E. Tests d'hypothèse : la démarche
On oppose deux hypothèses : l'hypothèse nulleH0 (le statu quo, ex. μ=μ0) et l'hypothèse alternativeH1. La démarche :
statistique de test : on standardise l'estimation. Moyenne, σ connu : z=σ/nx−μ0 (loi normale). Moyenne, σ inconnu : t=s/nx−μ0 (Student Tn−1). Proportion : z=p0(1−p0)/nf−p0.
risque α (souvent 5%) : probabilité maximale de rejeter H0 à tort.
région de rejet : test bilatéralH1:μ=μ0 → on rejette si ∣z∣>z1−α/2 (deux queues α/2). Test unilatéralH1:μ>μ0 (resp. <) → on rejette si z>z1−α (resp. z<−z1−α, une seule queue).
p-value : probabilité, si H0 est vraie, d'observer une statistique au moins aussi extrême. On rejette H0⟺p≤α. Bilatéral : p=2P(Z≥∣z∣)=2(1−Φ(∣z∣)) ; unilatéral : p=1−Φ(z) si H1:μ>μ0, p=Φ(z) si H1:μ<μ0 (la moitié du p bilatéral seulement quand z est du côté de H1).
Deux types d'erreur : 1ʳᵉ espèce = rejeter H0 alors qu'elle est vraie (probabilité α) ; 2ᵈᵉ espèce = conserver H0 alors qu'elle est fausse (probabilité β, la puissance étant 1−β).
F. Tests du khi-deux
La statistique est toujours χ2=∑E(O−E)2(O effectifs observés, Eattendus sous H0). On rejette H0 si χ2>χν;1−α2.
Ajustement (adéquation) : H0 « les données suivent une loi donnée ». Degrés de liberté ν=k−1(k classes).
Indépendance : H0 « les deux variables d'un tableau de contingence sont indépendantes ». Effectif attendu d'une case =totaltotal ligne×total colonne ; degrés de liberté ν=(r−1)(c−1).
G. Comparaison de deux échantillons
Deux moyennes (échantillons indépendants, grands n) : z=s12/n1+s22/n2x1−x2.
Deux proportions : on estime une proportion groupéep=n1+n2k1+k2 et z=p(1−p)(1/n1+1/n2)f1−f2.
Contrôle systématique. Vérifier le bon nombre de degrés de liberté(n−1 pour une variance, k−1 ou (r−1)(c−1) pour un khi-deux) ; le caractère uni- ou bilatéral du test (il change le seuil et la p-value) ; la cohérence décision ⟺p≤α ; et que les conditions d'application (n grand, effectifs attendus ≥5) sont réunies.
Dans le palier approfondissement (Pro) : Régression & corrélation, Monte-Carlo, fiabilité & chaînes de Markov
A. Régression linéaire par les moindres carrés
B. Corrélation et coefficient de détermination
C. Test de significativité de la pente
D. Méthode de Monte-Carlo
E. Fiabilité
F. Chaînes de Markov
La suite dans l'app Maths Post-Bac
Palier approfondissement, 54 exercices corrigés pas à pas, quiz, tuteur IA,
PDF téléchargeables et suivi de progression — pour BUT, BTS, licence et maths de l'ingénieur.